Technical appendix

Applied LLM engineering
не ML-research

Как устроен AI-слой Al-ina: prod vs prototype, почему не fine-tune, hybrid scoring, validation pipeline. Ниже — полный pipeline от сырого аудио до visit_*.json.

Pipeline · от сырых данных до результата

Prod-путь batch-смены: микрофон на рабочем месте → OGG-смена → STT → SQLite → сегментация → DeepSeek → JSON → дашборд. Код: transcription_analyzer/.
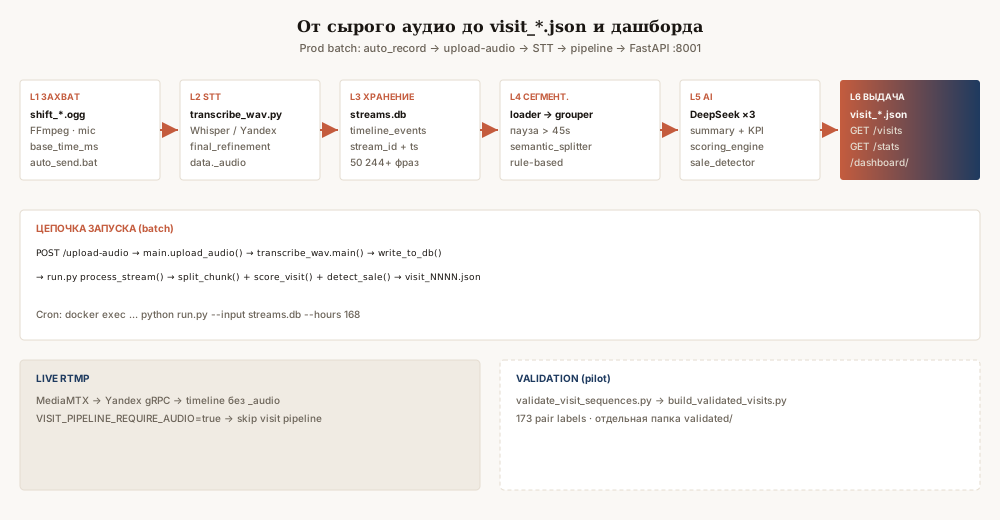
Сквозной pipeline: захват, STT, streams.db, сегментация, AI, visit JSON и дашборд
Шесть слоёв prod-контура. Основной путь — batch upload (auto_record.batauto_send.batPOST /upload-audio). Live RTMP пишет в ту же streams.db, но без _audio metadata не попадает в visit pipeline.
L1
Захват
Вход: микрофон салона
Выход: shift_*.ogg + meta
client_tools/auto_record.bat
client_tools/auto_send.bat
L2
STT
Вход: OGG/WAV смены
Выход: final_refinement + _audio
scripts/transcribe_wav.py
Whisper (batch) · Yandex (live)
L3
Хранение
Вход: STT-события
Выход: timeline_events
streams.db · server/db/timeline-repository.ts
L4
Сегментация
Вход: фразы по stream_id
Выход: candidate-visits
loader.py → grouper.py → semantic_splitter.py
L5
AI-анализ
Вход: raw_text визита
Выход: summary, KPI, sale
pipeline.py · scoring_engine · sale_detector
L6
Выдача
Вход: visit_*.json
Выход: UI + API
main.py :8001 · /dashboard/
#ЭтапМодульФункция / триггерФормат данных
L1Запись сменыauto_record.batFFmpeg mic → OGGshift_YYYYMMDD.ogg, base_time_ms
L1Uploadmain.pyupload_audio() → BackgroundTasksmultipart: file + stream_id
L2Batch STTtranscribe_wav.pytranscribe_whisper() / transcribe_yandex()row: {text, _audio{recording_id, segment_*}}
L2Live STTtranscription/session.tsemitTranscription() → gRPCrow без _audio (не в visit pipeline)
L3Timeline DBloader.pyload_sqlite()DataFrame: stream_id, timestamp_ms, clean_text
L4STT-сессииpipeline.py_split_into_stt_sessions()группы фраз, пауза > 45 сек
L4Visit splitsemantic_splitter.pysplit_chunk()candidate: raw_text, ts_start/end, pending
L5Summarypipeline.py_call_deepseek_visit()JSON: summary, client_request, outcome…
L5KPIscoring_engine.pyscore_visit()score_pct, score_level, t2 / ПС rubric
L5Salesale_detector.pydetect_sale()sale_status, sale_evidence, confidence
L6Savepipeline.pyprocess_stream()visit_NNNN_hash.json
L6APImain.pyGET /visits, GET /statsJSON list + агрегаты для UI

Сегментация STT-потока

Rule-based splitter без LLM на каждую границу — cost control. LLM вызывается только после формирования candidate-visit.
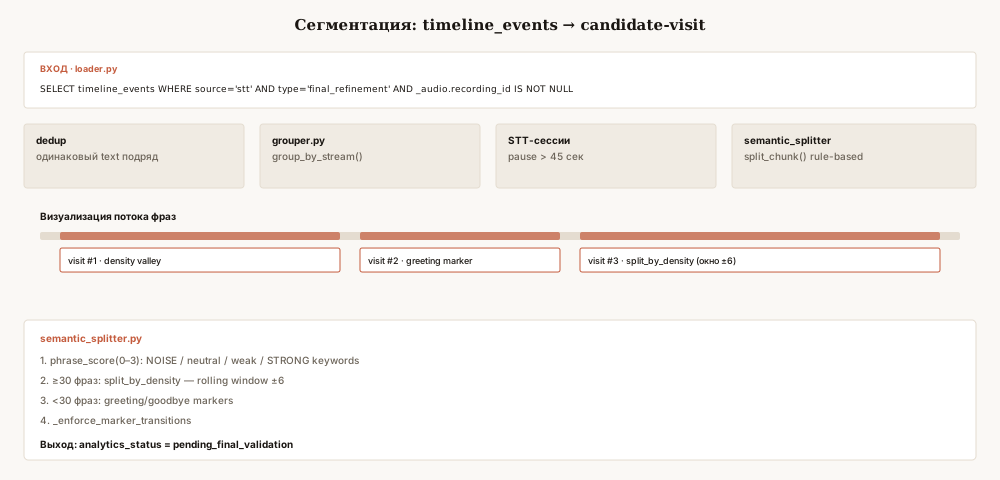
Диаграмма сегментации: loader, grouper, STT-сессии, semantic_splitter
phrase_score (0–3) → density valleys (окно ±6) или greeting/goodbye markers. Статус до AI: analytics_status: pending_final_validation.

AI-слой и visit JSON

Три вызова DeepSeek на визит (summary, KPI, sale) — только если perform_final_analytics=True. Sale detector: algo first, AI на хвосте 35% фраз если algo не уверен.
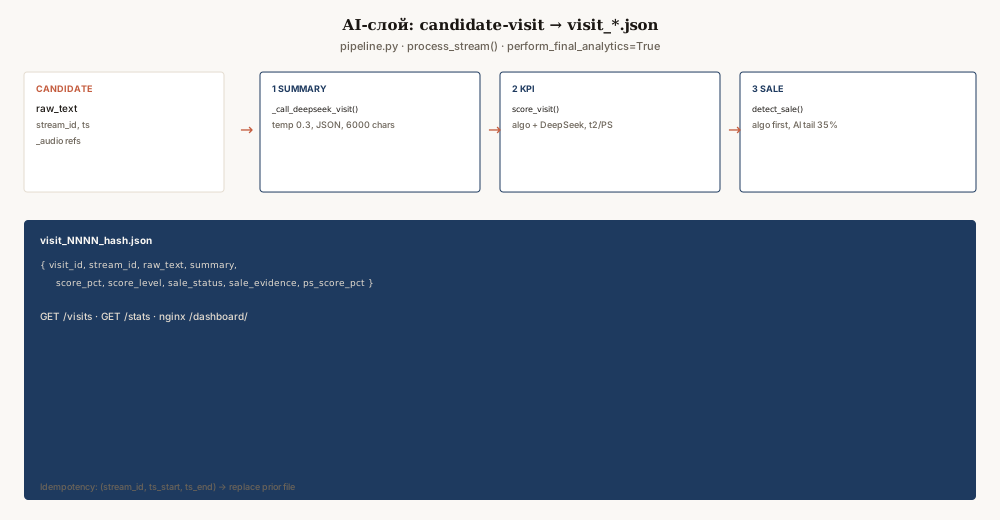
AI-анализ: DeepSeek summary, scoring_engine, sale_detector, visit JSON
Итоговый visit_*.json — idempotent по (stream_id, ts_start, ts_end). Опционально: _export_visit_audio_segment() → WAV/OGG клипа визита.

Инфографика: pipeline → prod UI

Слева — схема обработки (код). Справа — скрин боевого дашборда с live API (без PII в расшифровках).
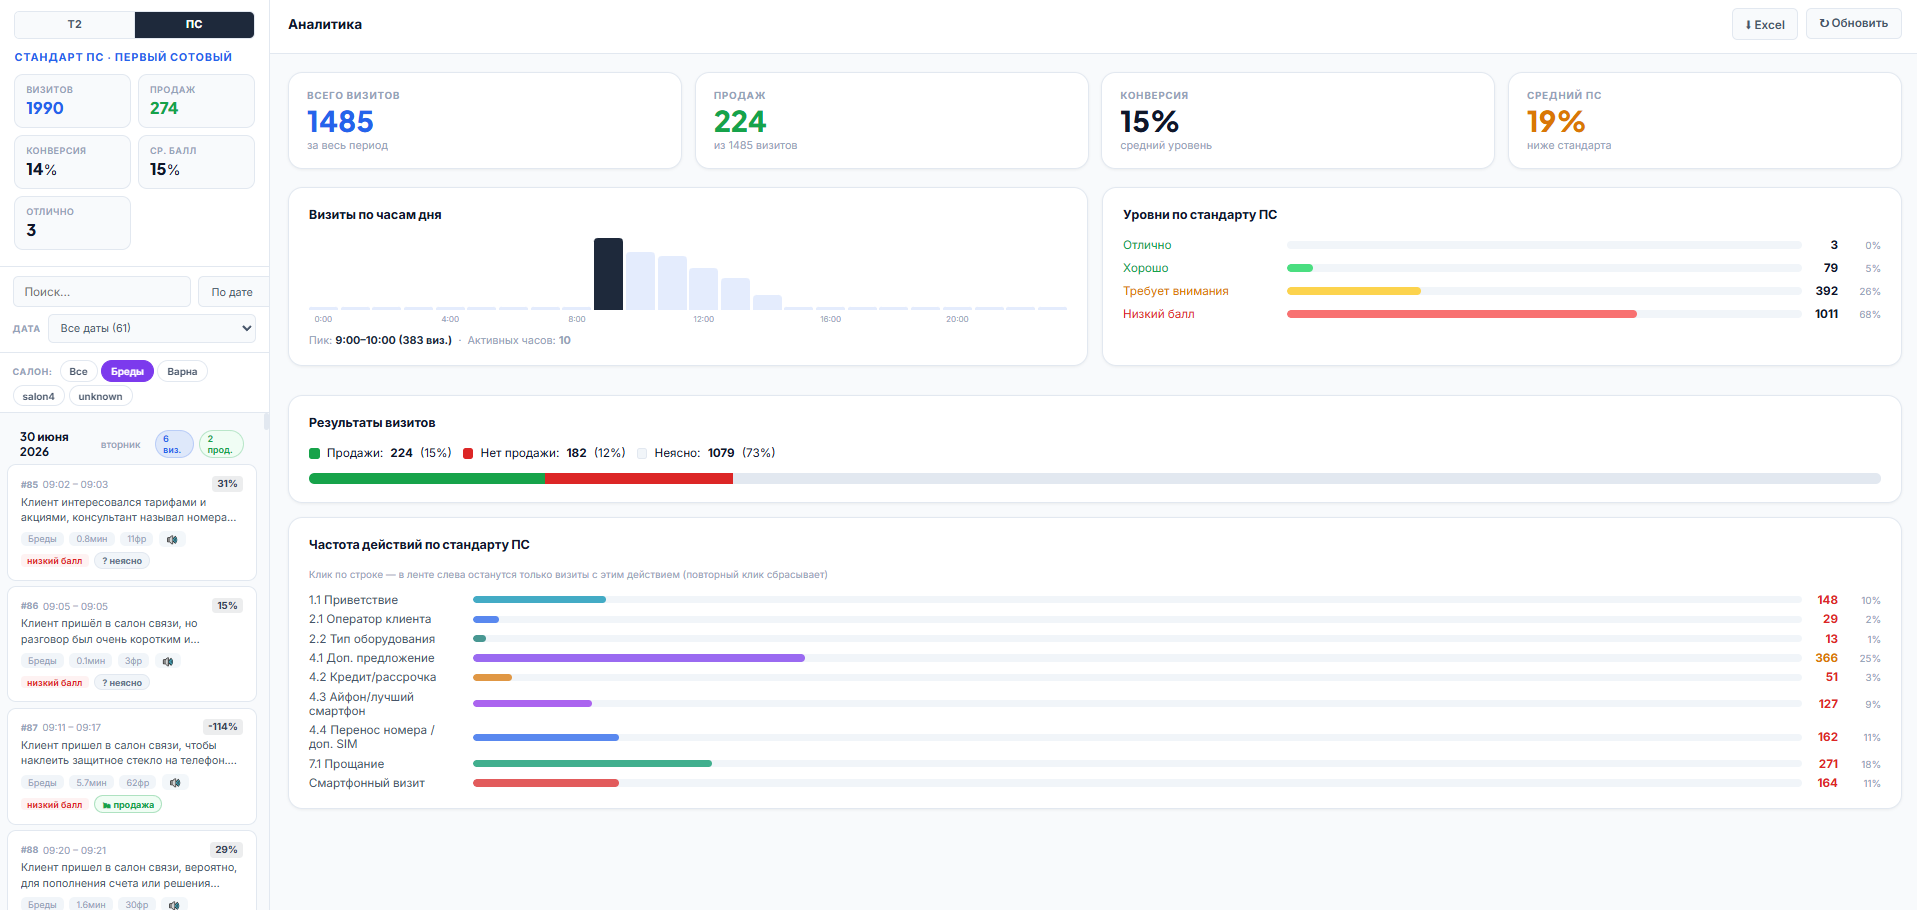
Pipeline от аудио до visit JSON
L1–L6: batch path + optional validation
Prod-дашборд Al-ina
GET /stats → UI · al-ina.ru/dashboard/
Validation pipeline (pilot) — второй слой поверх primary visits
visit_*.json validate_visit_sequences.py pairwise LLM merge build_validated_visits.py validated/

Primary pipeline не перезаписывает raw visits. Validation layer: pairwise check соседних candidate-visits → cluster merge → re-run DeepSeek на объединённом тексте. 173 pair labels в ML corpus. Документация: transcription_analyzer/docs/VISIT_VALIDATION_PIPELINE.md.

LLM stack

Prod

DeepSeek Chat

  • Summary + KPI: temperature 0.3, response_format: json_object
  • Sale detector: temperature 0.1, анализ хвоста 35% фраз
  • Лимит текста: 6000 символов на визит
  • Delay между вызовами: ~1 с (rate limit / cost control)
Prototype

Pairwise validation LLM

  • Соседние candidate-visits → merge / do_not_merge
  • Cluster validation: real_customer_visit / staff_talk / noise
  • Output: validated visits в отдельной папке
Не используем

Fine-tune / custom training

Мало gold-разметки на старте; rubric меняется под клиента (t2 → ПС). Быстрее iteration через промпт + rule layer. ML-merge — supervised roadmap, не замена LLM.

Prod · без LLM

semantic_splitter

Разбивка STT-потока на визиты — чисто алгоритмически: phrase_score, rolling window, valley detection, greeting/goodbye anchors. LLM не вызывается на каждую границу — cost + latency.

Retrieval & signals

Prod

Keyword + regex

  • STRONG_KEYWORDS в semantic_splitter (сим, тариф, MNP…)
  • Algo flags в scoring_engine: greeting, MNP, profanity, neg_company
  • Sale markers: «ваша подпись», «активировали», blockers «буду думать»
Prototype

Vector RAG / tariff KB

База тарифов t2 в промпте rubric, не в vector store. RAG по продуктовому каталогу — roadmap для KPI 1.2 (корректность фактов).

timeline_events loader (dedup) sessions (30s pause) semantic_splitter DeepSeek ×3 visit_*.json

Guardrails

Structured output

  • JSON-only responses с фиксированными полями KPI
  • Fatal: profanity / neg_company → score обнуляется algo-слоем
  • score_low_data при <15 фраз

Domain & roles

  • Промпт явно: «учитывай ошибки STT»
  • Два policy profile: t2 standard vs ПС (extended checklist)
  • Sale AI только если algo не дал уверенный вердикт

Eval — бизнес-метрики, не BLEU

Prod metrics

  • Доля sale_status = неясно (сейчас ~73%)
  • Manual review sample на validated subset
  • Pairwise validation report → merge graph quality

Этап 2 eval

  • Sale detector vs POS-касса (ground truth)
  • Precision/recall на staff_talk vs customer_visit
  • CatBoost pairwise merge — F1 на labeled pairs

Infra

Docker Compose
mediamtx          → RTMP / RTSP / HLS
web (Node.js)     → STT, timeline, API :5000
transcription-analyzer (FastAPI) → pipeline + dashboard :8001
nginx             → al-ina.ru, /dashboard/ proxy
  • VPS Linux, volumes: streams.db, visit_*.json
  • STT fallback: STT_BACKEND=whisper|yandex в .env
  • Client: Windows Task Scheduler → auto_record / auto_send

STT A/B · 06.04.2026

Один prod-файл 48,5 мин — реальный замер Whisper vs оценка Яндекс.

ПараметрWhisper (faster-whisper small)Yandex SpeechKit
Стоимость 48,5 мин0 ₽~730 ₽ (15 ₽/мин)
Время обработки21 мин (real)~5 мин (estimate)
VAD / тишина46% убраноНет
Точные word timestamps<0,1 с±25 с (chunks)
gRPC real-time stream
РешениеWhisper для batch-смен · Yandex для RTMP live

ML roadmap

Next

Pairwise merge classifier

CatBoost на features: gap_sec, service_ratio, TF-IDF cosine. Labels из validated clusters + manual review.

Next

Validated visits as gold

Primary pipeline не перезаписывает raw visits. Validation layer → отдельный output → metrics только на validated subset.

Чего нет

  • 1000 RPS / streaming LLM на каждую фразу
  • Custom fine-tuned model
  • Vector RAG в prod
  • RAGAS / BLEU eval pipeline
  • Deterministic backbone + LLM там, где нужен смысл
  • Hybrid sale detector — cost-aware
  • Validation architecture для ML без big-bang rewrite